> This page is for Da videocamera a cloud.
> For clean Markdown of any page, append .md to the page URL.
> For a complete documentation index, see https://next.developer.frame.io/llms.txt.
> For AI client integration (Claude Code, Cursor, etc.), connect to the MCP server at https://next.developer.frame.io/_mcp/server.
# Guida pratica: Organizzare le risorse
## Introduzione
In questa guida impareremo come e fino a che punto possiamo controllare *dove* vengono caricate le risorse della tua integrazione.
## Cosa serve?
Se non hai letto la guida [Implementazione C2C: configurazione](./implementing-c2c-setting-up), dalle un'occhiata veloce prima di continuare! Avrai anche bisogno dell'`access_token` ricevuto durante la guida all'autenticazione e all'autorizzazione per l'[hardware C2C](./implementing-c2c-authentication-and-authorization-hardware) o l'[applicazione C2C](./implementing-c2c-authentication-and-authorization-c2c-application).
## Struttura delle cartelle delle risorse
Per impostazione predefinita, le risorse vengono create con la seguente struttura di cartelle:
`Cloud Devices` > `{YYYY}_{MM}_{DD}` > `{ASSET_TYPE}` > `{YOUR_DEVICE}` > `{ASSET_NAME}` Dove `{ASSET_TYPE}` è `VIDEO`, `AUDIO` o `DATA` (configurato per il modello del dispositivo per canale), `{YOUR_DEVICE}` è il nome del dispositivo di progetto collegato al progetto dell'utente e `{ASSET_NAME}` è il nome della risorsa caricata, nonché la risorsa effettivamente riproducibile in Frame.io.
### Instradamento delle estensioni
Puoi configurare il dispositivo in modo che instradi le diverse risorse verso cartelle `{ASSET_TYPE}` personalizzate in base all'estensione file contenuta in `{ASSET_NAME}`. Ad esempio, supponiamo che la tua integrazione produca diversi tipi di file, ciascuno dei quali con una provenienza specifica. Puoi chiederci di mappare queste risorse nel seguente modo:
```text
.mov -> VIDEO
.mp4 -> VIDEO
.raw -> STILLS
.jpeg -> STILLS
.pdf -> CAMERA REPORTS
.las -> LiDAR Scans
```
Ora, quando crei la seguente risorsa:
```shell
{
curl -X POST https://api.frame.io/v2/assets \
--header 'Authorization: Bearer [access_codes]' \
--header 'Content-Type: application/json' \
--header 'x-client-version: 2.0.0' \
--data-binary @- <<'__JSON__'
{
"name": "IMAGE_0001.jpeg",
"filetype": "image/jpeg",
"filesize": 21136250,
"offset": 10
}
__JSON__
} | python -m json.tool
```
La documentazione per `/v2/assets` si [trova qui](/camera-to-cloud/api-reference/device-asset-create)
... verrà instradata in una posizione come: `Dispositivi cloud` > `2022_04_01` > `STILLS` > `MY_DEVICE` > `IMAGE_0001.jpeg`. Se invece il nome del file fosse `A001_C001.mov`, verrebbe instradato qui: `Cloud Devices` > `2022_04_01` > `VIDEO` > `MY_DEVICE` > `A001_C001.mov`.
### Percorsi di caricamento tokenizzati
Alcune integrazioni potrebbero voler avere un controllo maggiore sulla struttura delle cartelle create dal loro dispositivo. [Frame.io](http://frame.io/) deve però assicurarsi che ci sia un certo livello di coerenza nel modo in cui i file vengono caricati su [Frame.io](http://frame.io/) da un dispositivo C2C, nonché garantire ai clienti [Frame.io](http://frame.io/) quale parte del loro progetto può interagire con un dispositivo C2C. A tal fine, consentiamo agli integratori di personalizzare le posizioni di caricamento delle risorse all'interno della cartella `{YOUR_DEVICE}`, ma non permettiamo di caricare le risorse al di fuori di quella cartella.
Per caricare in una struttura di cartelle personalizzata, dovrai collaborare con il tuo partner manager. Le strutture di cartelle personalizzate sono un insieme di metadati tokenizzati che devono essere forniti durante la creazione delle risorse. Facciamo un esempio semplice:
Supponiamo di avere una fotocamera 3D con valori `reel_name` come `"A001"`, `"A002"`, `"A003"` ecc. e valori `clip_number` come `"C001"`, `"C002"` ecc. Vogliamo creare delle cartelle per ogni clip e popolarle con i file dell'occhio sinistro e destro. I file in un progetto dovrebbero avere questo aspetto: 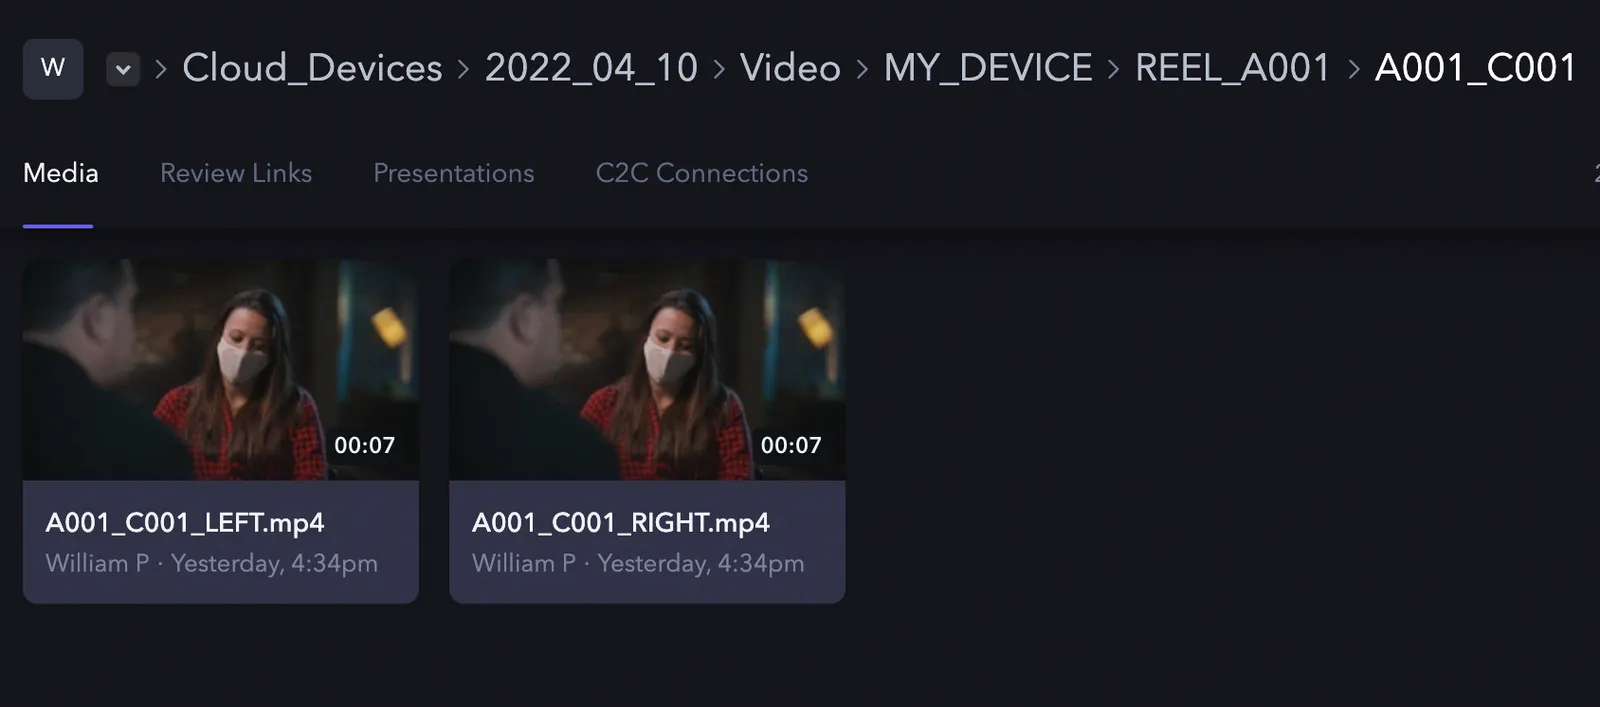
Per farlo, dobbiamo configurare due impostazioni:
* Campi di metadati obbligatori
* Percorso file tokenizzato
I campi di metadati obbligatori sono un semplice elenco di chiavi che devono essere impostate al momento della creazione della risorsa per l'integrazione:
```text
[reel_name, clip_number]
```
Puoi quindi usare una qualsiasi di queste chiavi per creare un percorso delimitato da `/`, utilizzando `{field_name}` per indicare dove deve essere inserito il valore di un campo:
```text
REEL_{reel_name}/{reel_name}_{clip_number}
```
Entrambe queste impostazioni dovranno essere fornite al nostro team [Frame.io](http://frame.io/) in modo che siano aggiunte all'interno dei dettagli dell'integrazione. Dopo aver configurato tutto, quando crei una risorsa, quei valori dovranno essere forniti al livello root del payload per permettere che la risorsa venga creata:
```shell
{
curl -X POST https://api.frame.io/v2/assets \
--header 'Authorization: Bearer [access_token]' \
--header 'Content-Type: application/json' \
--header 'x-client-version: 2.0.0' \
--data-binary @- <<'__JSON__'
{
"name": "A001_C001_LEFT.mp4",
"filetype": "video/mp4",
"filesize": 21136250,
"offset": 10,
"metadata": {
"reel_name": "A001",
"clip_number": "C001"
},
}
__JSON__
} | python -m json.tool
```
Il codice in alto creerà un file con un percorso completo simile a questo: `Dispositivi cloud` > `2022_04_01` > `VIDEO` > `MY_DEVICE` > `REEL_A001` > `A001_C001` > `A001_C001_LEFT.mp4`
Se il dispositivo non è stato configurato esplicitamente per consentire questi campi, riceverai un errore se provi a effettuare la stessa chiamata. Allo stesso modo, se configuri dei campi di metadati obbligatori, DEVI fornirli nel payload di creazione della risorsa, altrimenti viene restituito un errore.
Il payload accetterà qualsiasi valore JSON valido. I valori che non sono di tipo stringa vengono visualizzati nel modo seguente:
* **interi**: visualizzati in base 10: `10` -> `"10"`
* **numeri in virgola mobile**: utilizza la rappresentazione più breve secondo l'algoritmo descritto in "Printing Floating-Point Numbers Quickly and Accurately" in Proceedings of the SIGPLAN '96 Conference on Programming Language Design and Implementation.
* **booleani**: `true` e `false` vengono visualizzati come `"true"` e `"false"`
* **null**: visualizzato come stringa vuota. Se `reel_name` fosse impostato su `null`, la prima cartella personalizzata verrebbe visualizzata come `REEL_`
In genere, suggeriamo di limitare i valori alle stringhe e di formattare gli altri valori come si ritiene opportuno. Ad esempio, i numeri interi saranno sempre stampati senza zeri iniziali, il che potrebbe non essere il comportamento desiderato.
In genere, dovrebbero essere utilizzati solo i campi con un valore valido per ogni clip; se un campo non ha sempre un valore valido, devi avere un piano per rappresentare i valori non impostati o null.
## Stack di versioni
[Frame.io](http://frame.io/) supporta gli [stack di versioni](https://support.frame.io/en/articles/4431-version-stacking-and-comparison), un modo per raggruppare più iterazioni dello stesso contenuto nell'interfaccia utente. L'API C2C consente ai dispositivi di caricare nuove iterazioni di una risorsa che verranno inserite in uno stack con le versioni precedenti. Per creare uno stack di versioni, devi fornire un `autoversion_id` che consenta di identificare a quali stack di versioni appartengono le risorse. Questo valore può essere qualsiasi cosa: un UUID, un nome file ecc. Fai attenzione a usare solo valori che non verranno mai ripetuti involontariamente in una cartella di risorse. Ad esempio, se è possibile che la tua integrazione possa creare lo stesso nome file più di una volta, allora il nome file *non* è un buon candidato da usare per `autoversion_id`.
Il valore di autoversion_id viene fornito così:
```shell
{
curl -X POST https://api.frame.io/v2/assets \
--header 'Authorization: Bearer [access_token]' \
--header 'Content-Type: application/json' \
--header 'x-client-version: 2.0.0' \
--data-binary @- <<'__JSON__'
{
"name": "A001_C001_v01.mov",
"filetype": "video/webm",
"filesize": 21136250,
"offset": 10,
"autoversion_id": "033e22ae-8544-4c9b-a84c-fcc140b0dd16"
}
__JSON__
} | python -m json.tool
```
Ora, ogni volta che carichi una nuova risorsa, se usi lo stesso autoversion_id, la risorsa verrà aggiunta come versione più recente in uno stack con la risorsa originale:
```shell
{
curl -X POST https://api.frame.io/v2/assets \
--header 'Authorization: Bearer [access_token]' \
--header 'Content-Type: application/json' \
--header 'x-client-version: 2.0.0' \
--data-binary @- <<'__JSON__'
{
"name": "A001_C001_v02_with_color.mov",
"filetype": "video/webm",
"filesize": 21136250,
"offset": 10,
"autoversion_id": "033e22ae-8544-4c9b-a84c-fcc140b0dd16"
}
__JSON__
} | python -m json.tool
```
*Le risorse verranno impilate solo se vengono caricate nella stessa cartella*, quindi dovrai tenere a mente un paio di cose se desideri implementare gli stack di versioni:
* I metadati tokenizzati devono risolversi nella stessa cartella padre affinché lo stack di versioni venga creato.
* Poiché la data di creazione fa parte del percorso del file, le nuove versioni create dopo mezzanotte UTC potrebbero non venire impilate correttamente, a meno che tu non fornisca un offset per l'ora di creazione del caricamento originale.
Questo secondo punto è importante. Supponiamo che venga creata una nuova versione della risorsa 48 ore dopo il caricamento iniziale. Per impilarla insieme alla risorsa originale, occorre fornire un offset di 48 ore nel passato: 172.800 secondi.
```shell
{
curl -X POST https://api.frame.io/v2/assets \
--header 'Authorization: Bearer [access_token]' \
--header 'Content-Type: application/json' \
--header 'x-client-version: 2.0.0' \
--data-binary @- <<'__JSON__'
{
"name": "A001_C001_v03_with_color.mov",
"filetype": "video/webm",
"filesize": 21136250,
"offset": 172800,
"autoversion_id": "033e22ae-8544-4c9b-a84c-fcc140b0dd16"
}
__JSON__
} | python -m json.tool
```
Se la risorsa attuale *fosse* stata caricata il giorno `2022_04_03`, ora verrà caricata il giorno `2022_04_01` e impilata con la risorsa corretta.
## Avanti
Questa è l'ultima guida per creare un'integrazione C2C davvero ottima! Prenditi un momento per festeggiare! Magari fai uno spuntino. L'unica cosa che resta da fare è rivedere la checklist dell'integratore, dove troverai un riepilogo di tutto il necessario per creare un'integrazione a prova di errore.
Se non l'hai già fatto, ti incoraggiamo a contattare il nostro team, poi continua con la prossima guida. A presto!